
Viele SEO-Probleme haben nichts mit Inhalten zu tun. Eine Seite kann hervorragend geschrieben sein und trotzdem nicht ranken, weil eine einzige robots.txt-Zeile den Crawler von genau der Anweisung fernhält, die eigentlich greifen sollte.
Dieser Artikel geht zehn technische Fehlerquellen durch, die sich in der Praxis immer wieder finden, jeweils mit der wörtlichen Google-Quelle dahinter. Grundlage sind die Google Search Essentials, die offizielle Core-Web-Vitals-Dokumentation und die aktuellen Spam-Policies.
Inhaltsverzeichnis
Core Web Vitals: Schwellenwerte und Messmethode
Bevor sich einzelne Fehler einordnen lassen, braucht es die korrekten Schwellenwerte. Core Web Vitals bestehen aus drei Metriken: Largest Contentful Paint für die Ladeleistung mit einem „gut"-Wert bis 2,5 Sekunden, Interaction to Next Paint für die Reaktionsfähigkeit bis 200 Millisekunden, und Cumulative Layout Shift für die visuelle Stabilität bis 0,1.
Entscheidend ist die Messmethode, die selten korrekt zitiert wird. Google bewertet am 75. Perzentil der Seitenaufrufe, getrennt nach Mobil und Desktop, und eine Seite besteht nur, wenn sie diesen Wert bei allen drei Metriken erreicht. Maßgeblich sind dabei Felddaten aus dem Chrome User Experience Report, nicht Labordaten. Lighthouse und ähnliche Labortools können INP grundsätzlich gar nicht messen, weil dafür eine echte Nutzerinteraktion nötig ist.
Was das für Sie bedeutet
Ein guter Lighthouse-Score sagt wenig darüber aus, ob die Core Web Vitals im Feld tatsächlich bestehen. Nur der reale Nutzerdaten-Report in Search Console oder PageSpeed Insights zeigt den relevanten Wert.
Fehler 1 bis 6: die klassischen Fehlkonfigurationen
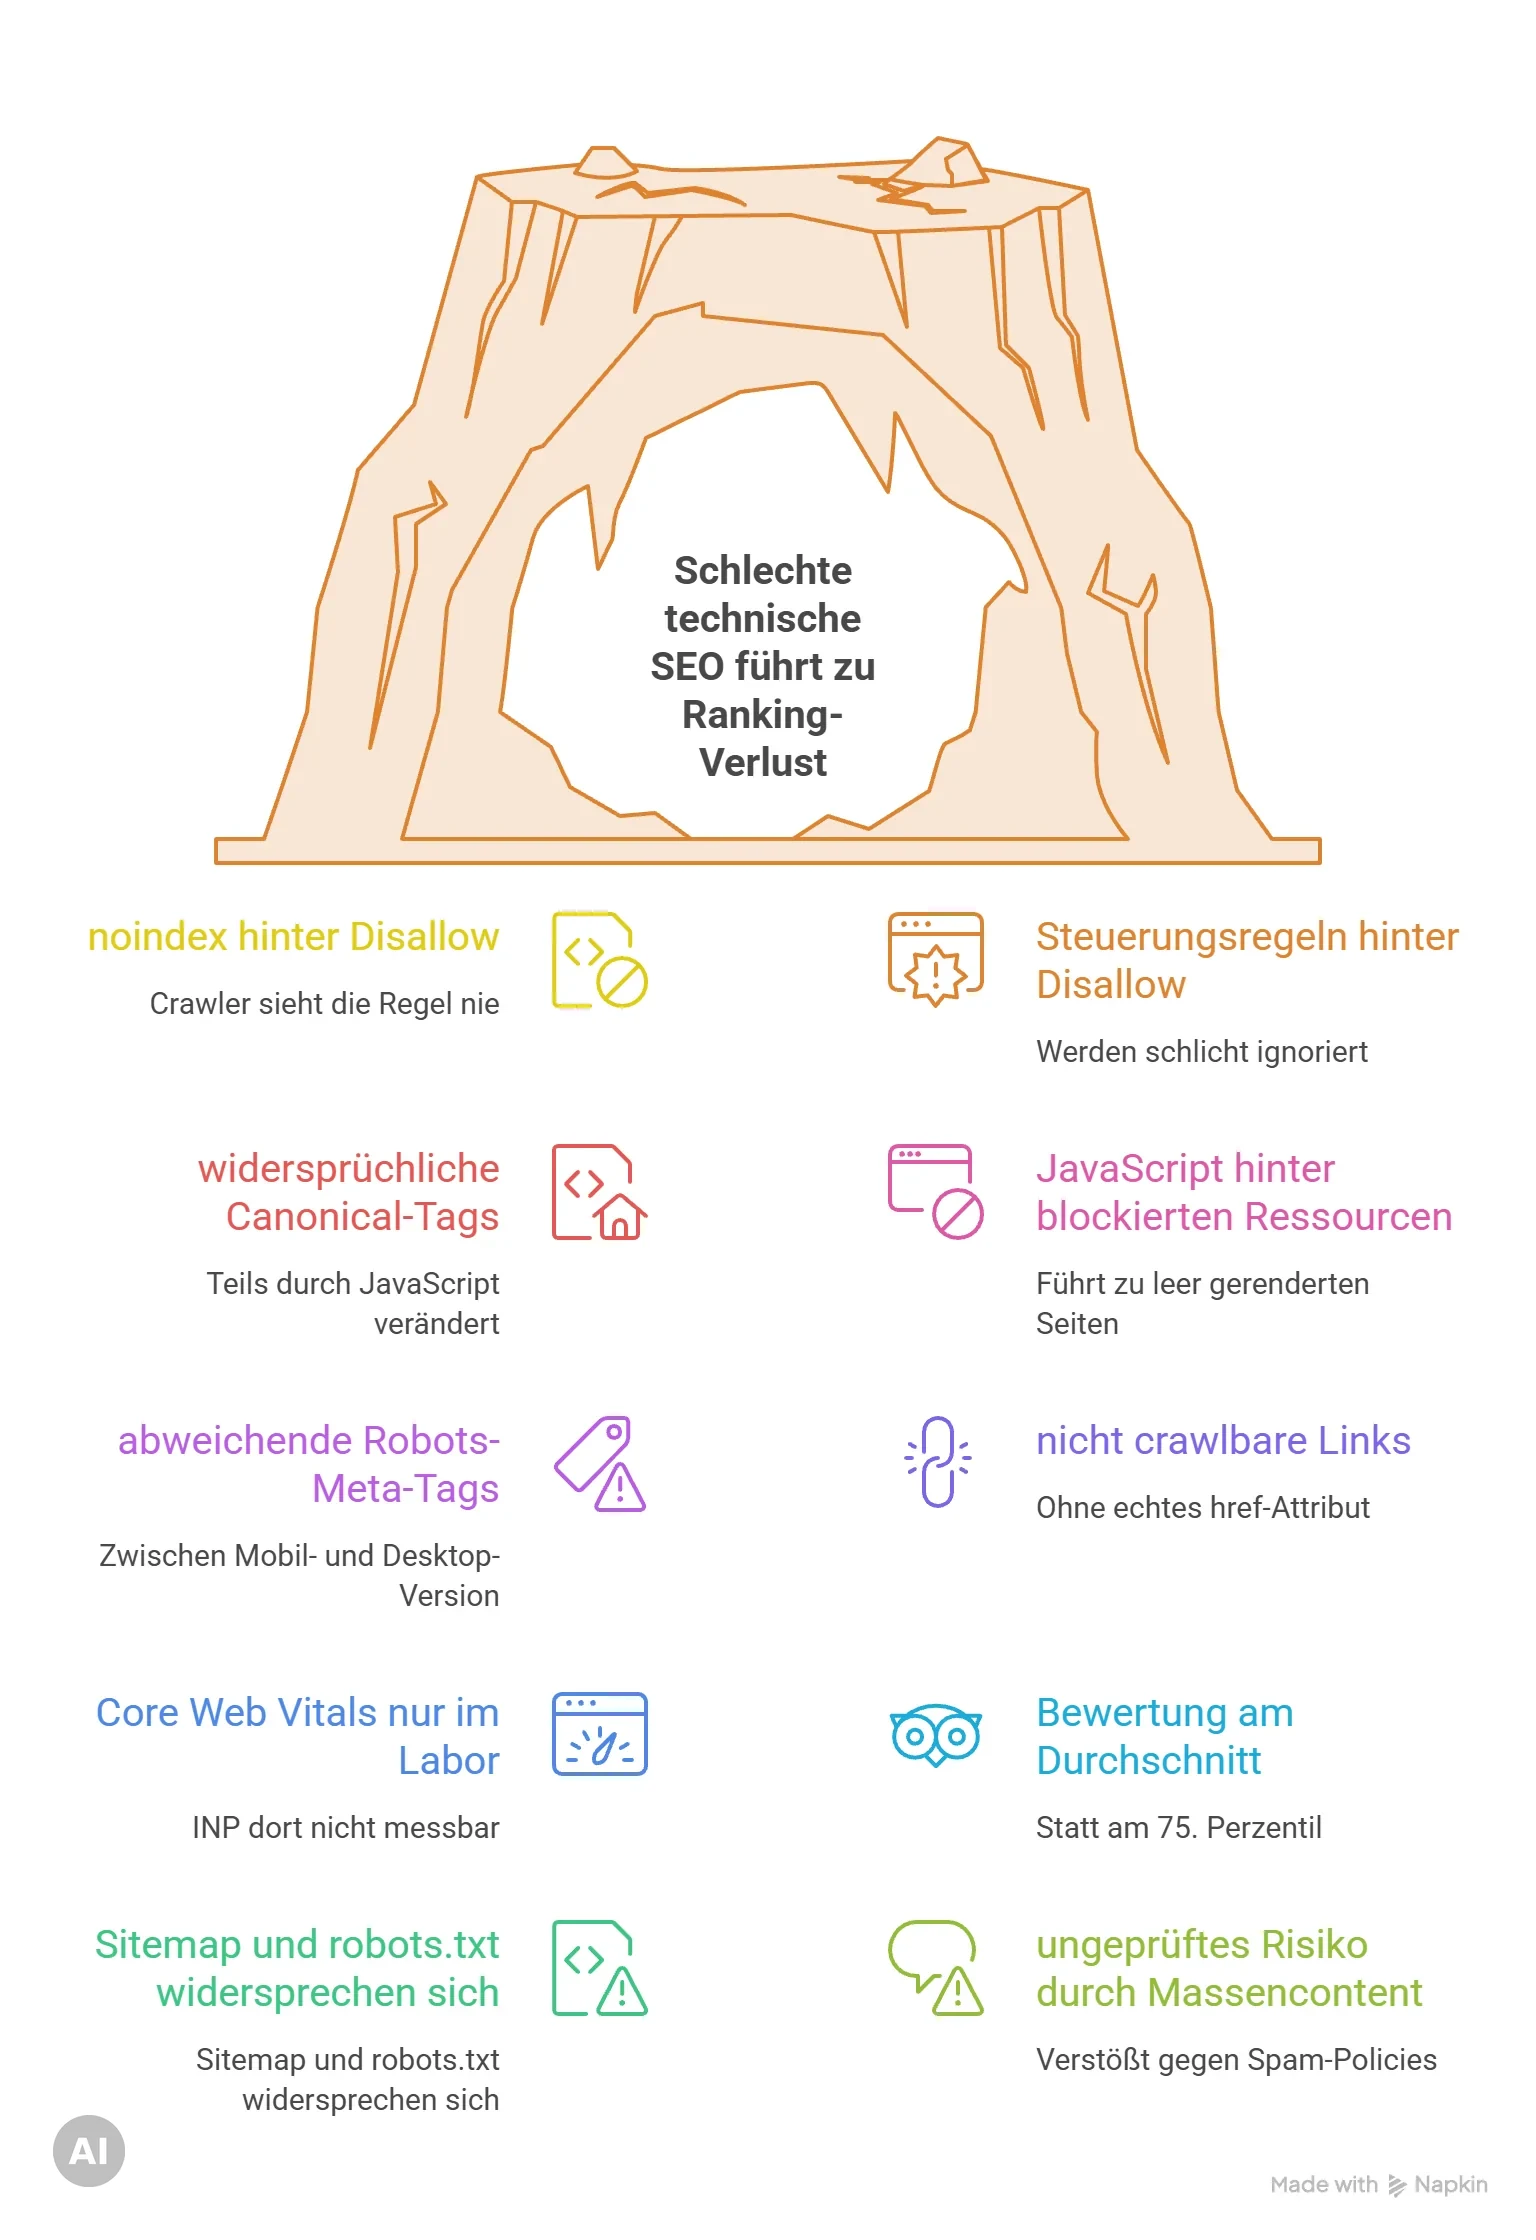
Der häufigste und folgenreichste Fehler ist noindex hinter einem robots.txt-Disallow zu verstecken. Google schreibt dazu wörtlich: Ist eine Seite durch robots.txt blockiert oder für den Crawler nicht erreichbar, sieht der Crawler die noindex-Regel nie, und die Seite kann trotzdem in den Suchergebnissen erscheinen.
Eng verwandt ist Fehler zwei: Steuerungsregeln hinter einem robots.txt-Disallow zu platzieren. Informationen zu Indexierung oder Auslieferung werden dann schlicht nicht gefunden und ignoriert. robots.txt regelt den Zugang, nicht die Indexierung. Fehler drei betrifft widersprüchliche oder mehrfache Canonical-Tags, die laut Google zu unerwarteten Ergebnissen führen können, besonders wenn die Canonical-URL zusätzlich per JavaScript auf einen anderen Wert geändert wird als im ursprünglichen HTML.
Fehler vier tritt vor allem bei SPA- und Framework-Sites auf: JavaScript hinter blockierten Ressourcen. Google rendert kein JavaScript aus gesperrten Dateien oder auf gesperrten Seiten, ein typischer Fall ist ein per robots.txt gesperrtes /assets/- oder /js/-Verzeichnis, das zu einer leer gerenderten Seite führt. Fehler fünf sind abweichende Robots-Meta-Tags zwischen Mobil- und Desktop-Version, die bei Mobile-First-Indexing dazu führen können, dass Google die Seite gar nicht crawlt. Fehler sechs sind nicht crawlbare Links, etwa Navigation, die nur über JavaScript oder Buttons statt über <a href> funktioniert.
Fehler 7 und 8: Core Web Vitals falsch gemessen
Fehler sieben besteht darin, Core Web Vitals ausschließlich in Labortools zu prüfen, obwohl dort INP gar nicht messbar ist. Fehler acht ist die Bewertung am Durchschnitt statt am 75. Perzentil, was ein zu optimistisches Bild der tatsächlichen Nutzererfahrung liefert. Beide Fehler führen dazu, dass ein vermeintlich gutes Ergebnis im echten Feldreport plötzlich nicht mehr besteht.
Wichtig für die Erwartungshaltung: Google formuliert die Ranking-Wirkung von Core Web Vitals bewusst vage und quantifiziert die Gewichtung gegenüber der Inhaltsqualität nicht. Jede konkrete Prozentangabe dazu im Netz ist erfunden. Core Web Vitals wirken eher als Tiebreaker und Conversion-Faktor, nicht als Ranking-Hebel erster Ordnung. Wer eine langsame Seite ohnehin schon Kampagnen-Traffic zuführt, verliert dadurch doppelt: schlechtere organische Sichtbarkeit und eine schlechtere Conversion-Rate im bezahlten Traffic.
Möchten Sie das konkret auf Ihren Betrieb anwenden?
Kostenlos Termin buchen Justin Kollautz
KI Spezialist · Wurzelwerk
Fehler 9 und 10: Sitemap-Widerspruch und Spam-Risiko
Fehler neun entsteht, wenn Sitemap und robots.txt sich widersprechen, etwa eine URL in der Sitemap gemeldet wird, die gleichzeitig per robots.txt gesperrt ist. Der Crawler bekommt dadurch widersprüchliche Signale und priorisiert im Zweifel die Sperre. Fehler zehn ist ungeprüftes Risiko durch Advertorial-Verzeichnisse oder KI-generierten Massencontent, der gegen aktuelle Spam-Policies verstößt, ohne dass es beim Erstellen so beabsichtigt war.
Spam-Policies 2026: die Neuerungen
Google führt in den Search Essentials eine vollständige Liste an Spam-Policies, von Cloaking über Keyword-Stuffing bis Sneaky Redirects. Zwei Policies mit hoher Aktualität verdienen besondere Aufmerksamkeit. Site Reputation Abuse, aktualisiert im November 2024, betrifft das Veröffentlichen von Drittanbieter-Inhalten auf einer etablierten Domain, um deren Ranking-Signale auszunutzen, unabhängig davon, ob der Domain-Betreiber selbst beteiligt war. Scaled Content Abuse betrifft den Einsatz generativer KI-Tools, um viele Seiten ohne echten Mehrwert zu erzeugen, ebenso wie das Anlegen einer eigenen Seite pro Suchvariante primär zur Ranking-Manipulation. Im April 2026 kam eine eigene Policy gegen sogenanntes Back Button Hijacking hinzu.
Wichtig für die Erwartungshaltung: Nach einem Verstoß gibt es keinen Reset-Knopf. Eine Site kann sich nach Korrekturen wieder verbessern, aber erst, wenn Googles automatisierte Systeme über Monate hinweg lernen, dass die Site inzwischen konform arbeitet.
FAQ
Warum erscheint eine Seite trotz noindex-Tag noch in der Google-Suche?
Meist, weil die Seite zusätzlich per robots.txt gesperrt ist. Der Crawler sieht das noindex-Tag dann nie, weil er die Seite gar nicht erst aufrufen darf, und listet sie weiterhin.
Wie wichtig sind Core Web Vitals wirklich für das Ranking?
Google quantifiziert die Gewichtung nicht und bezeichnet sie eher als Tiebreaker denn als Ranking-Hebel erster Ordnung. Für die Conversion-Rate und Nutzererfahrung bleiben sie trotzdem relevant.
Warum wird meine JavaScript-Seite bei Google leer angezeigt?
Häufigste Ursache ist ein per robots.txt gesperrtes Ressourcenverzeichnis, etwa /js/ oder /assets/. Google kann das JavaScript dann nicht laden und rendert die Seite ohne den dynamisch erzeugten Inhalt.
Was passiert, wenn ich unwissentlich gegen eine Spam-Policy verstoße?
Die Site rankt niedriger oder verschwindet teilweise aus dem Index. Nach einer Korrektur kann sich das Ranking wieder erholen, allerdings erst über einen Zeitraum von Monaten, da Googles Systeme die Konformität erneut beobachten müssen.
Fazit
Die meisten dieser zehn Fehler entstehen nicht durch fehlendes SEO-Wissen, sondern durch Standardeinstellungen von CMS-Systemen oder Entwicklungsteams, die nie gegen die Google-Dokumentation geprüft wurden. Eine einmalige technische Durchsicht deckt die häufigsten Fälle zuverlässig auf. Dieselbe technische Grundlage entscheidet auch darüber, ob eine Seite überhaupt für KI-gestützte Suchfunktionen wie AI Overviews infrage kommt, wie der Beitrag zu Digitalisierungsfehlern im Mittelstand am größeren Bild zeigt.